


Mysql——事务隔离级别与MVCC
四个数据库并发问题
脏读(Dirty Read):一个事务读取数据并且对数据进行了修改,这个修改对其他事务来说是可见的,即使当前事务没有提交。这时另外一个事务读取了这个还未提交的数据,但第一个事务突然回滚,导致数据并没有被提交到数据库,那第二个事务读取到的就是脏数据,这也就是脏读的由来。
丢失修改(Lost to modify):在一个事务读取一个数据时,另外一个事务也访问了该数据,那么在第一个事务中修改了这个数据后,第二个事务也修改了这个数据。这样第一个事务内的修改结果就被丢失,因此称为丢失修改。
不可重复读(Unrepeatable read):指在一个事务内多次读同一数据。在这个事务还没有结束时,另一个事务也访问该数据。那么,在第一个事务中的两次读数据之间,由于第二个事务的修改导致第一个事务两次读取的数据可能不太一样。这就发生了在一个事务内两次读到的数据是不一样的情况,因此称为不可重复读。
幻读(Phantom read):在一个事务读取了几行数据,接着另一个并发事务插入了一些数据时。在随后的查询中,第一个事务就会发现多了一些原本不存在的记录,就好像发生了幻觉一样,所以称为幻读。
事务隔离级别
SQL定义的事务隔离级别分为四级:
READ UNCOMMITTED 读未提交:允许读取未被提交的数据。
READ COMMITTED 读已提交:只允许读取已被提交的数据。
REPEATABLE READ 可重复读 :可重复读。
SERIALIZABLE 串行执行:所有事务严格串行执行。
对应的会产生的并发问题:
| 脏读 | 不可重复读 | 幻读 | |
|---|---|---|---|
| READ UNCOMMITTED | × | × | × |
| READ COMMITTED | × | × | |
| REPEATABLE READ | × | ||
| SERIALIZABLE |
但对于Mysql的innodb,其REPEATABLE READ使用了MVCC + 临键锁 Next-key Lock,可以解决幻读问题。
InnoDB行锁
记录锁(Record Lock):属于单个行记录上的锁。
间隙锁(Gap Lock):锁定一个范围,不包括记录本身。
临键锁(Next-Key Lock):Record Lock+Gap Lock,锁定一个范围,包含记录本身,主要目的是为了解决幻读问题。记录锁只能锁住已经存在的记录,为了避免插入新记录,需要依赖间隙锁。
MySQL事务隔离级别与实现
MySQL InnoDB 默认使用的隔离级别为REPEATABLE READ 可重复读。
对于每种级别的具体实现如下:
READ UNCOMMITTED:无
READ COMMITTED:MVCC(在每次Select前生成Read View)
REPEATABLE READ :MVCC(只在事务第一次Select前生成Read View) + Next-key Lock
SERIALIZABLE:锁
MySQL InnoDB的RR级别如何解决幻读的?
1、执行普通 select,此时会以 MVCC 快照读的方式读取数据
在快照读的情况下,RR 隔离级别只会在事务开启后的第一次查询生成 Read View ,并使用至事务提交。所以在生成 Read View 之后其它事务所做的更新、插入记录版本对当前事务并不可见,实现了可重复读和防止快照读下的 “幻读”。
2、执行 select…for update/lock in share mode、insert、update、delete 等当前读
在当前读下,读取的都是最新的数据,如果其它事务有插入新的记录,并且刚好在当前事务查询范围内,就会产生幻读!InnoDB 使用 Next-key Lock来防止这种情况。当执行当前读时,会锁定读取到的记录的同时,锁定它们的间隙,防止其它事务在查询范围内插入数据。只要我不让你插入,就不会发生幻读。
MVCC(多版本并发控制)
MVCC 是一种并发控制机制,用于在多个并发事务同时读写数据库时保持数据的一致性和隔离性。它是通过在每个数据行上维护多个版本的数据来实现的。当一个事务要对数据库中的数据进行修改时,MVCC 会为该事务创建一个数据快照,而不是直接修改实际的数据行。
1、读操作(SELECT):
当一个事务执行读操作时,它会使用快照读取。快照读取是基于事务开始时数据库中的状态创建的,因此事务不会读取其他事务尚未提交的修改。具体工作情况如下:
- 对于读取操作,事务会查找符合条件的数据行,并选择符合其事务开始时间的数据版本进行读取。
- 如果某个数据行有多个版本,事务会选择不晚于其开始时间的最新版本,确保事务只读取在它开始之前已经存在的数据。
- 事务读取的是快照数据,因此其他并发事务对数据行的修改不会影响当前事务的读取操作。
2、写操作(INSERT、UPDATE、DELETE):
当一个事务执行写操作时,它会生成一个新的数据版本,并将修改后的数据写入数据库。具体工作情况如下:
- 对于写操作,事务会为要修改的数据行创建一个新的版本,并将修改后的数据写入新版本。
- 新版本的数据会带有当前事务的版本号,以便其他事务能够正确读取相应版本的数据。
- 原始版本的数据仍然存在,供其他事务使用快照读取,这保证了其他事务不受当前事务的写操作影响。
3、事务提交和回滚:
- 当一个事务提交时,它所做的修改将成为数据库的最新版本,并且对其他事务可见。
- 当一个事务回滚时,它所做的修改将被撤销,对其他事务不可见。
4、版本的回收:
为了防止数据库中的版本无限增长,MVCC 会定期进行版本的回收。回收机制会删除已经不再需要的旧版本数据,从而释放空间。
MVCC 通过创建数据的多个版本和使用快照读取来实现并发控制。读操作使用旧版本数据的快照,写操作创建新版本,并确保原始版本仍然可用。这样,不同的事务可以在一定程度上并发执行,而不会相互干扰,从而提高了数据库的并发性能和数据一致性。
InnoDB对于MVCC的实现
MVCC 的实现依赖于:隐藏字段、Read View、undo log。
隐藏字段
在内部,InnoDB 存储引擎为每行数据添加了三个隐藏字段:
DB_TRX_ID(6字节):表示最后一次插入或更新该行的事务 id。此外,delete操作在内部被视为更新,只不过会在记录头Record header中的deleted_flag字段将其标记为已删除DB_ROLL_PTR(7字节)回滚指针,指向该行的undo log。如果该行未被更新,则为空DB_ROW_ID(6字节):如果没有设置主键且该表没有唯一非空索引时,InnoDB会使用该 id 来生成聚簇索引
ReadView
ReadView是一个数据结构,属于事务,主要用来进行可见性判断。
1 | class ReadView { |

undo log
undo log 主要有两个作用:
- 当事务回滚时用于将数据恢复到修改前的样子
- 另一个作用是
MVCC,当读取记录时,若该记录被其他事务占用或当前版本对该事务不可见,则可以通过undo log读取之前的版本数据,以此实现非锁定读
在 InnoDB 存储引擎中 undo log 分为两种:insert undo log 和 update undo log:
insert undo log:指在insert操作中产生的undo log。因为insert操作的记录只对事务本身可见,对其他事务不可见,故该undo log可以在事务提交后直接删除。不需要进行purge操作。update undo log:update或delete操作中产生的undo log。该undo log可能需要提供MVCC机制,因此不能在事务提交时就进行删除。提交时放入undo log链表,等待purge线程进行最后的删除。
不同事务或者相同事务的对同一记录行的修改,会使该记录行的 undo log 成为一条链表,链首就是最新的记录,链尾就是最早的旧记录。

最终流程
当用户在这个事务中要读取某个记录行的时候,InnoDB 会将该记录行的 DB_TRX_ID 与 Read View 中的一些变量及当前事务 ID 进行比较,判断是否满足可见性条件,具体的:
- 取出该记录行的
DB_TRX_ID,判断是否可见:- DB_TRX_ID >= m_low_limit_id 的肯定不可见;
- DB_TRX_ID < m_up_limit_id 的肯定可见;
- 对于中间的,要看DB_TRX_ID是否在活跃事务列表m_ids中,在说明不可见,不在说明可见;
- 如果可见,那么该记录行的值对于这次Read View是可见的;
- 如果不可见,在该记录行的 DB_ROLL_PTR 指针所指向的
undo log取出快照记录,用快照记录的 DB_TRX_ID 跳到步骤 1 重新开始判断,直到找到满足的快照版本或返回空。 - 最后返回满足可见性的结果。
RC和RR隔离级别下MVCC的差异
在事务隔离级别 RC 和 RR 下,InnoDB 存储引擎使用 MVCC(非锁定一致性读),但它们生成 Read View 的时机却不同:
- 在 RC 隔离级别下的
每次select查询前都生成一个Read View(m_ids 列表) - 在 RR 隔离级别下只在事务开始后
第一次select数据前生成一个Read View(m_ids 列表)
由于RR隔离级别下只在事务开始后第一次select数据前生成一个Read View,所以整个事务的所有select可见性是一致的,这就保证了可重复读。
Mysql——索引
数据结构
哈希表
可以O(1)的检索数据;
hash索引由于数据是随机的,不支持顺序和范围查询;
二叉查找树
性能依赖于平衡程度,最坏情况下会退化至O(n);
AVL树(自平衡二叉查找树)
进行 O(logn) 次数的旋转操作,需要频繁地进行旋转操作来保持平衡,会有较大的计算开销;
每个树节点仅存储一个数据,因此一次磁盘IO只能获取一个数据;
红黑树
插入和删除节点时只需进行 O(1) 次数的旋转和变色操作;
平衡性相对较弱,可能会导致树的高度较高,导致一些数据需要进行多次磁盘 IO 操作才能查询到;
每个树节点仅存储一个数据,因此一次磁盘IO只能获取一个数据;
更适合数据在内存的情况;
B树(多路平衡二叉树)
所有节点既存放key也存放data;
B+树
只有叶子节点存放 key 和 data,其他内节点只存放 key,因此检索的效率都是稳定的;
每个叶子节点有一条引用链指向与它相邻的叶子节点;进行范围查询时,只需要找到下界后,对链表进行遍历即可;
每个节点存放多个key或data,减少了树高,而且一次磁盘IO可以取多个值,减少了IO次数。
聚簇索引与非聚簇索引
在innodb中,主键索引是聚簇索引,即索引结构和数据一起存放的索引。
其他所有索引都是二级索引,也是非聚簇索引,这些索引存的是主键。当使用二级索引查询到主键后,还要再到主键索引去查询,称为回表。
不过非聚簇索引不一定回表查询,如果SQL查的字段正好被索引覆盖了,那就没必要回表了,这种称为覆盖索引。
联合索引
使用表中的多个字段创建索引,就是 联合索引,也叫 组合索引 或 复合索引。
最左前缀匹配原则
最左前缀匹配原则指的是在使用联合索引时,MySQL 会根据索引中的字段顺序,从左到右依次匹配查询条件中的字段。如果查询条件与索引中的最左侧字段相匹配,那么 MySQL 就会使用索引来过滤数据,这样可以提高查询效率。
最左匹配原则会一直向右匹配,直到遇到范围查询(如 >、<)为止。对于 >=、<=、BETWEEN 以及前缀匹配 LIKE 的范围查询,不会停止匹配。
原理:联合索引的底层如下图所示,可以看到,a 是全局有序的(1, 2, 2, 3, 4, 5, 6, 7 ,8),而 b 是全局是无序的(12,7,8,2,3,8,10,5,2)。只有在 a 相同的情况才,b 才是有序的,比如 a 等于 2 的时候,b 的值为(7,8),即局部有序。
因此如果查询 where a>2 and b=7,可以使用到索引a,但在a>2的情况下,b是无序的,因此无法使用到索引b。
而如果查询 where a>=2 and b=7,虽然a>2的时候用不了索引b,但在a=2的时候,b是有序的,因此可以使用到索引b,然后后面再用链表遍历。

索引下推
索引下推(Index Condition Pushdown,简称 ICP) 是 MySQL 5.6 版本中提供的一项索引优化功能,它允许存储引擎在索引遍历过程中,执行部分 WHERE字句的判断条件,直接过滤掉不满足条件的记录,从而减少回表次数,提高查询效率。
对于查询SELECT * FROM user WHERE zipcode = '431200' AND MONTH(birthdate) = 3;,其中的 birthdate 字段使用函数导致索引失效。
没有索引下推之前,即使 zipcode 字段利用索引可以帮助我们快速定位到 zipcode = '431200' 的用户,但我们仍然需要对每一个找到的用户进行回表操作,获取完整的用户数据,再去判断 MONTH(birthdate) = 3。
有了索引下推之后,存储引擎会在使用zipcode 字段索引查找zipcode = '431200' 的用户时,同时判断MONTH(birthdate) = 3。这样,只有同时满足条件的记录才会被返回,减少了回表次数。
MySQL 可以简单分为 Server 层和存储引擎层这两层。Server 层处理查询解析、分析、优化、缓存以及与客户端的交互等操作,而存储引擎层负责数据的存储和读取,MySQL 支持 InnoDB、MyISAM、Memory 等多种存储引擎。
索引下推的下推其实就是指将部分上层(Server 层)负责的事情,交给了下层(存储引擎层)去处理。
除了可以减少回表次数之外,索引下推还可以减少存储引擎层和 Server 层的数据传输量。
索引失效
以下情况会导致索引失效:
- 当select * 且 where 范围查找过大时,有可能直接走全表扫描而不是使用索引;
- 联合索引,但未遵循最左匹配原则;
- 在索引列上进行计算、函数、类型转换等操作(因为索引保存的是索引字段的原始值,而不是经过函数计算后的值);
- 以 % 开头的 LIKE 查询比如
LIKE '%abc';; - 查询条件中使用 OR,且 OR 的前后条件中有一个列没有索引,涉及的索引都不会被使用到;
- IN 或 NOT IN的取值范围较大时会导致索引失效,走全表扫描
- 发生隐式转换,当 where 查询操作符左边为字符类型时发生了隐式转换,会导致索引失效;
隐式转换
当操作符与不同类型的操作数一起使用时,会发生类型转换以使操作数兼容。某些转换是隐式发生的。
两个参数至少有一个是
NULL时,比较的结果也是NULL,特殊的情况是使用<=>对两个NULL做比较时会返回1,这两种情况都不需要做类型转换;两个参数都是字符串,会按照字符串来比较,不做类型转换;
两个参数都是整数,按照整数来比较,不做类型转换;
十六进制的值和非数字做比较时,会被当做二进制串;
有一个参数是
TIMESTAMP或DATETIME,并且另外一个参数是常量,常量会被转换为timestamp;有一个参数是
decimal类型,如果另外一个参数是decimal或者整数,会将整数转换为decimal后进行比较,如果另外一个参数是浮点数,则会把decimal转换为浮点数进行比较;所有其他情况下,两个参数都会被转换为浮点数再进行比较;
关于第7条,具体的:
不以数字开头的字符串都将转换为
0。如'abc'、'a123bc'、'abc123'都会转化为0;以数字开头的字符串转换时会进行截取,从第一个字符截取到第一个非数字内容为止。比如
'123abc'会转换为123,'012abc'会转换为012也就是12,'5.3a66b78c'会转换为5.3,其他同理。
因此,隐式转化可能导致索引失效,如下:
SELECT * FROM test1 WHERE num1 = '10000';左边为 int 类型10000,转换为浮点数还是10000,右边字符串类型'10000',转换为浮点数也是10000。两边的转换结果都是唯一确定的,所以不影响使用索引。SELECT * FROM test1 WHERE num2 = 10000;左边是字符串类型'10000',转浮点数为 10000 是唯一的,右边int类型10000转换结果也是唯一的。但是,因为左边是检索条件,'10000'转到10000虽然是唯一,但是其他字符串也可以转换为10000,比如'10000a','010000','10000'等等都能转为浮点数10000,这样的情况下,是不能用到索引的。
Mysql——三大日志
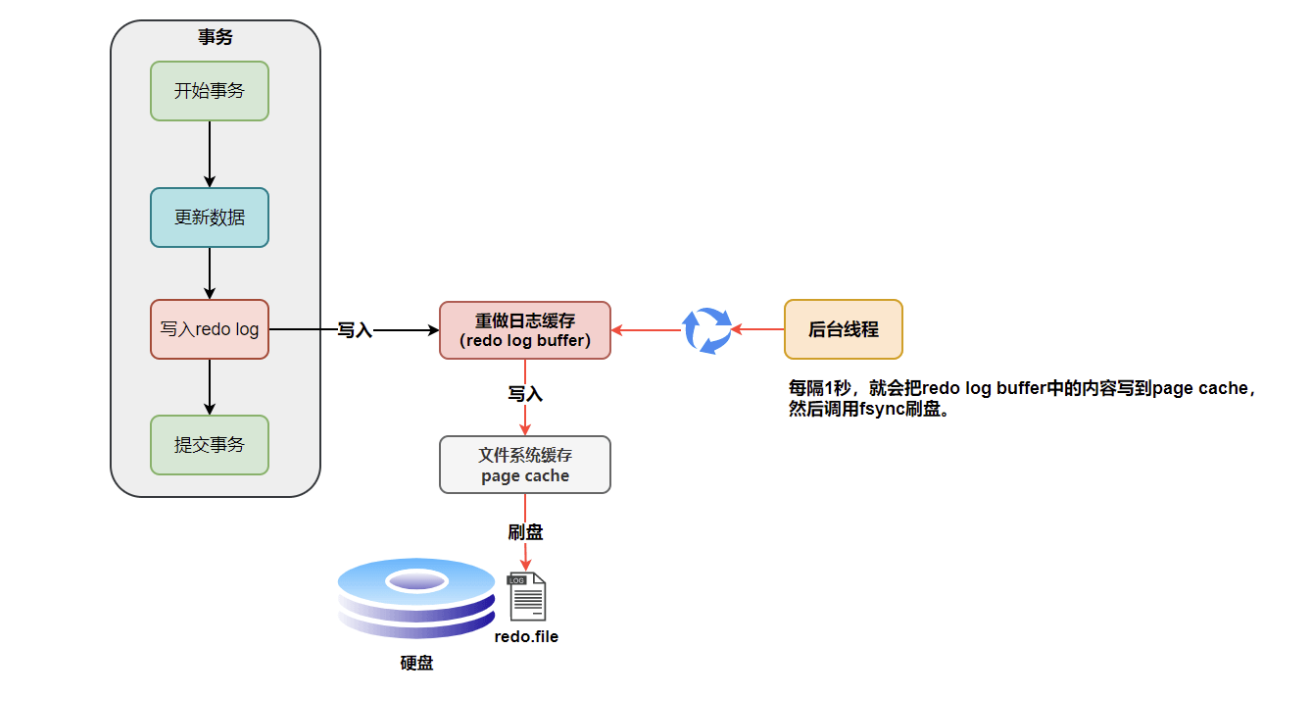
Redo log 重做日志
作用:redo log为innodb独有,用于崩溃恢复,保证数据的持久性和完整性。
刷盘时机
- 根据innodb_flush_log_at_trx_commit:
- 0:每次事务提交不进行刷盘
- 1:每次事务提交都进行刷盘
- 2:每次事务提交,将log buffer中的redo log写入page cache
- 当log buffer中缓存的redo log占其容量约一半时,进行刷盘
- 当事务日志缓冲区(transaction log buffer)满时,触发刷盘
- innodb定期执行检查点操作,将内存中脏数据刷新到磁盘,并将对应redo log一并刷新
- innodb有一个后台线程,周期性地(1秒)将脏页与相关redo log刷新到磁盘
- mysql服务器关闭时,会刷新
Java并发——线程池
线程池参数
1 | public ThreadPoolExecutor(int corePoolSize,//线程池的核心线程数量 |
未命名
Redis数据结构
String
其value为字符串,根据字符串的格式不同,可以分为3类:
- string:普通字符串
- int:整数类型,可以做自增、自减操作
- float:浮点类型,可以做自增、自减操作
不管哪种格式,底层都是字节数组形式存储,只不过编码方式不同。字符串类型的最大空间不超过512M。

String类型常见命令:
- SET、GET、MSET、MGET
- INCR:让一个整型的key自增1
- INCRBY:让一个整型的key自增指定步长
- INCRBYFLOAT:让一个浮点类型的数字自增指定步长
- SETNX:添加一个String类型的键值对,前提是这个key不存在,否则不执行
- SETEX:添加一个String类型的键值对,并且指定有效期
项目中的应用:
- 以 前缀“phone:“ + 手机号码 为key,存储验证码。
- 可以将java对象序列化为JSON字符串,然后存储到string中。
- 利用INCR命令实现全局唯一ID。
Hash
hash类型,也叫散列,其value是一个无序字典,类似于hashmap结构。
如果使用string存储对象,当需要修改对象某个字段时很不方便,而hash结构可以将对象中的每个字段独立存储,可以针对单个字段做CRUD。

Hash类型常见命令:
- HSET key field value:添加或修改field的值
- HGET
- HMSET、HMGET
- HGETALL key:一次性获取key中的所有field和value
- HKEYS:获取所有field
- HVALS:获取所有value
- HINCYBY
- HSETNX:添加一个hash类型的key的filed值,前提是这个field不存在,否则不执行
项目中的应用:
- 存储用户信息
1 | Map<String, Object> userMap = BeanUtil.beanToMap(userDTO, new HashMap<>(), |
List
Set
SortedSet
Redis的SortedSet是一个可排序的set集合,里面的每一个元素都带有一个score属性,可以基于score属性对元素排序,其底层的实现是一个跳表(SkipList)+ hash表。
sortedset具有以下特性:
- 可排序
- 元素不重复
- 查询速度快
常见命令:
- ZADD key score member:添加一个或多个元素到sortedset,如果已经存在则更新其score
- ZREM key member:删除一个指定元素
- ZSCORE key member:获取指定元素的score
- ZRANK key member:获取指定元素的排名
- ZCARD key:获取sortedset中的元素个数
- ZCOUNT key min max:统计score值在给定范围内的所有元素的个数
- ZINCRBY key increment member:让指定元素自增
- ZRANGE key min max:按score排序后,获取指定排名范围内的元素
- ZRANGEBYSCORE key min max:按score排序后,获取指定score范围内的元素
- ZDIFF、ZINTER、ZUNION:求差集、交集、并集
在项目中应用:
点赞排行榜:为每个博客维护一个sortedset,记录所有点过赞的用户,并用score来存时间戳。这样按照score排序,就能按照时间先后顺序排序。
Feed流的滚动分页:由于Feed流中的数据会不断更新,导致数据的角标也在变化,因此不能采用穿透的分页模式,只能采用滚动分页。为达到效果,使用redis中的sortedset数据结构来存储消息和时间戳,分页查询时,从上次查询的最小时间戳开始查。
![image-20250221192829761]()

Geo
Geo即Geolocation的简写,代表地理坐标,Redis在3.2版本加入了对GEO的支持。
Geo常用命令:
- GEOADD:添加一个地理空间信息,包含:经度(longitude)、维度(latitude)、值(member)
- GEODIST:计算指定的两个点之间的距离并返回
- GEOHASH:将指定member的坐标转为hash字符串形式并返回
- GEOPOS:返回指定member的坐标
- GEORADIUS:指定圆心、半径,找到该圆内的所有member,并按距离排序返回。6.2后废弃
- GEOSEARCH:在指定范围内搜索member,并按距离排序返回。范围可以是圆形或矩形。6.2新功能
- GEOSEARCHSTORE:与GEOSEARCH功能一致,不过可以把结果存储到一个指定的key中。6.2新功能
在项目中应用:
- 附近商户功能:使用Geo来存储商户地理信息,并应用GEOSEARCH来查找附近商户。
BitMap
Redis中利用string类型数据结构实现Bitmap,最大上限为512M,即2^32个bit位。
BitMap的命令:
SETBIT:向指定位置(offset)存入一个0或1
GETBIT:获取指定位置(offset)的bit值
BITCOUNT:统计BitMap中值为1的bit位的数量
BITFIELD:操作(查询、修改、自增)BitMap中的指定位置(offset)的值
BITFIELD_RO:获取BitMap中的bit数组,并以十进制返回
BITOP:将多个BitMap的结果做位运算(与、或、异或)
BITOPS:查找bit数组中指定范围内第一个0或1出现的位置
项目中应用:
- 可以用BitMap实现用户签到功能,用“前缀 + 用户id + 年月”作为key,存储用户每一个月的签到结果。把每一个bit位对应当月的每一天,用户签到则将对应那一日的bit为设置为1。

HyperLogLog
Hypeloglog(HLL)是从Loglog算法派生的概率算法,用以确认非常大的集合的基数,而不需要存储其所有值。
Redis中的HLL是基于string结构实现的,单个HLL的内存永远小于16kb。作为代价,其测量结果是概率性的,有小于0.81%的误差,但对于UV统计来说,是可以忽略的。
HyperLogLog命令:
- PFADD key element [element …]:向指定key添加一个元素
- PFCOUNT key:统计指定key中元素个数(基于概率的)
- PFMERGE destkey sourcekey 合并两个key
应用:
- UV统计
UV:Unique Visitor,独立访客量,指通过互联网访问网页的自然人,1天内同一个用户多次访问网站,只记录1次。
PV:Page View,页面访问量或点击量,用户每访问网页的一个页面,记录一次PV,多次打开则多次记录PV。往往用来衡量网站的流量。
UV统计在服务端做比较麻烦,因为要判断该用户是否已经统计过了,需要将统计过的用户信息保存。但如果每个访问的用户都保存到Redis中,数据量会非常恐怖。
登录注册
验证码登录
使用session进行登录存在session共享问题:多台Tomcat并不共享session存储空间,当切换到不同tomcat服务时会导致数据丢失。因此基于redis实现共享session登录。
客户端根据收到的验证码填入并登录,服务端收到请求之后,从Redis中校验验证码和手机号是否匹配,如果匹配就成功登录,则将用户的信息保存到Redis中,并返回随机token给客户端;客户端后续请求都带着这个token在作为autorization放在请求头里面。

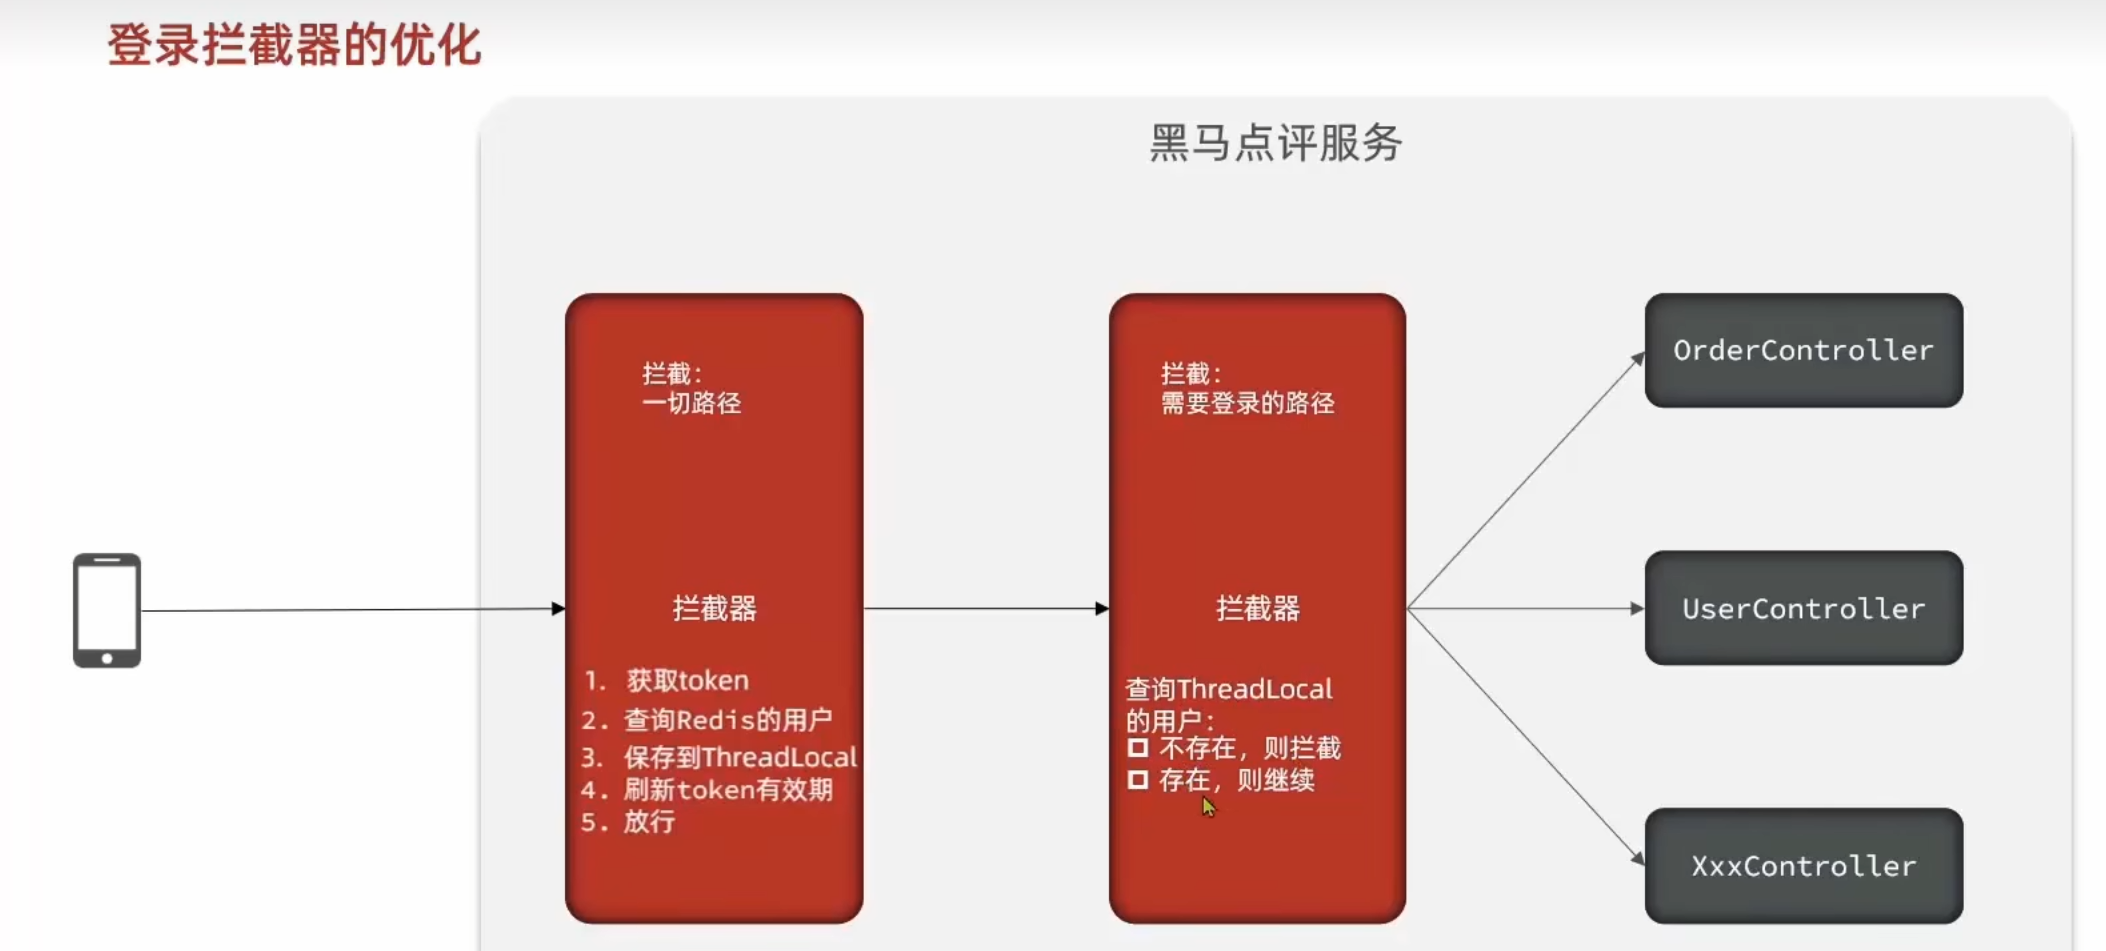
登录拦截器
登录拦截器设置成两个拦截器,第一个拦截器拦截一切路径,进行获取token、查询redis用户、保存到ThreadLocal和刷新token有效期,而第二个拦截器才拦截需要登录的路径,查询ThreadLocal中的用户是否不存在,不存在则拦截。
这样所有路径都可以刷新token有效期,也就是用户点击任何页面都能刷新登录状态。
商户查询缓存
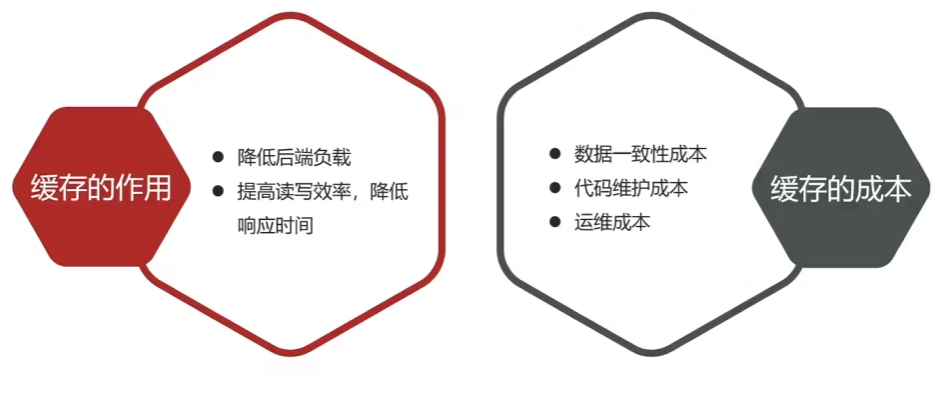
缓存就是数据交换的缓冲区(cache),存贮数据的临时地方,一般读写性能较高。
缓存更新策略
缓存更新策略
| 内存淘汰 | 超时剔除 | 主动更新 | |
|---|---|---|---|
| 说明 | 不用自己维护,利用Redis的内存淘汰机制,当内存不足时自动淘汰部分数据,当内存不足时自动淘汰部分数据。下次查询时更新缓存。 | 给缓存数据添加TTL时间,到期后自动删除缓存。下次查询时更新缓存。 | 编写业务逻辑,在修改数据库的同时,更新缓存。 |
| 一致性 | 差 | 一般 | 好 |
| 维护成本 | 无 | 低 | 高 |
业务场景:
- 低一致性需求:使用内存淘汰机制。例如店铺类型的缓存。
- 高一致性需求:主动更新, 并以超时剔除作为兜底方案。例如店铺详情的缓存。
主动更新策略
| Cache Aside Pattern | Read/Write Through Pattern | Write Behind Caching Pattern |
|---|---|---|
| 由缓存的调用者,在更新数据库的同时更新缓存。 | 缓存与数据库整合为一个服务,由服务来维护一致性。调用者调用该服务,无需关心缓存一致性问题。 | 调用者只操作缓存,由其他线程异步的将缓存数据持久化到数据库,保证最终一致。 |
| 调用者需要写一些代码 | 维护一个这样的服务复杂,成本高 | 效率高,但维护异步服务难,可靠性和一致性较差 |
采用Cache Aside Pattern。
如何操作数据库和缓存
删除缓存还是更新缓存?
- 更新缓存:每次更新数据库都更新缓存,无效写操作较多。
- 删除缓存:更新数据库时让缓存失效,查询时在更新缓存。√
如何保证缓存与数据库的操作的同时成功或失败?
- 单体系统:将缓存与数据库操作放在一个事务。
- 分布式系统:利用TCC等分布式事务方案。
先操作缓存还是先操作数据库?(线程安全问题)
![image-20250215150429038]()
- 由于更新数据库操作比较缓慢,而查询数据库和写入缓存操作很快,线程2很容易趁虚而入,因此该情况发生概率高。
![image-20250215150750330]()
发生该情况需要满足:1.两个线程并行;2.缓存恰好失效;3.在线程1查询缓存和写入缓存两个操作的微秒级空隙内,线程2完成更新数据库和删除缓存操作。因此该情况发生的概率很低。
因此先操作数据库再删除缓存。


缓存更新策略的最佳实践方案
- 低一致性需求:使用Redis自带的内存淘汰机制
- 高一致性需求:主动更新, 并以超时剔除作为兜底方案
- 读操作:
- 缓存命中则直接返回
- 缓存未命中则查询数据库,并写入缓存,设定超时时间
- 写操作
- 先写数据库,然后再删除缓存
- 要确保数据库与缓存事务的原子性
- 读操作:
缓存穿透
缓存穿透是指客户端请求的数据在缓存中和数据库中都不存在,这样缓存永远不会生效,这些请求都会打到数据库。例如,一个不怀好意的黑客同时间内大量请求不存在的数据,这些请求都会打到数据库上,导致数据库崩溃。
常见的解决方案有两种:缓存空对象和布隆过滤。
其他解决方案:增强id的复杂度,避免被猜测id规律;做好数据的基础格式校验;加强用户权限校验;做好热点参数的限流。
缓存空对象
查询时发现数据在数据库中不存在,则在redis中缓存一个空对象并设置过期时间。这样以后查询的数据不存在时,会命中缓存。
- 优点:实现简单,维护方便
- 缺点:
- 额外的内存消耗(解决:设置TTL)
- 可能造成短期的不一致(例如,用户查询不存在得数据,缓存设置未null,此时数据库更新,用户再次查询仍然为null)(可以在新增数据时插入缓存,覆盖null)
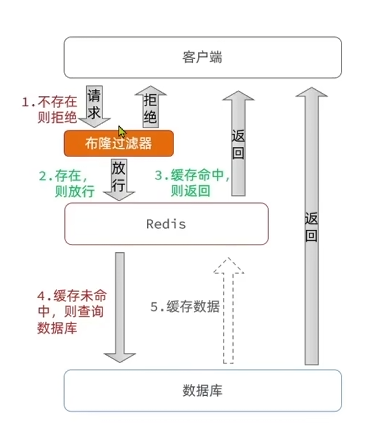
布隆过滤
添加一个布隆过滤器,用来判断数据是否存在。查询缓存前需经过过滤器。
Redis中布隆过滤器底层为一个大型位数组(二进制数组)+多个无偏hash函数
优点:内存占用较少,没有多余key
缺点:
- 实现复杂
- 存在误判可能(可能有数据不存在但放行的情况)
缓存雪崩
缓存雪崩是指在同一时段大量的缓存key同时失效或者Redis服务宕机,导致大量请求到达数据库,带来巨大压力。
解决方案:
- 给不同的Key的TTL添加随机值,用以预防同一时段大量的缓存key同时失效
- 利用Redis集群提高服务的可用性
- 给缓存业务添加降级限流策略
- 给业务添加多级缓存
缓存击穿
缓存击穿问题也叫热点Key问题,就是一个被高并发访问并且缓存重建业务较复杂的key突然失效了,无数的请求访问在瞬间给数据库带来巨大的冲击。
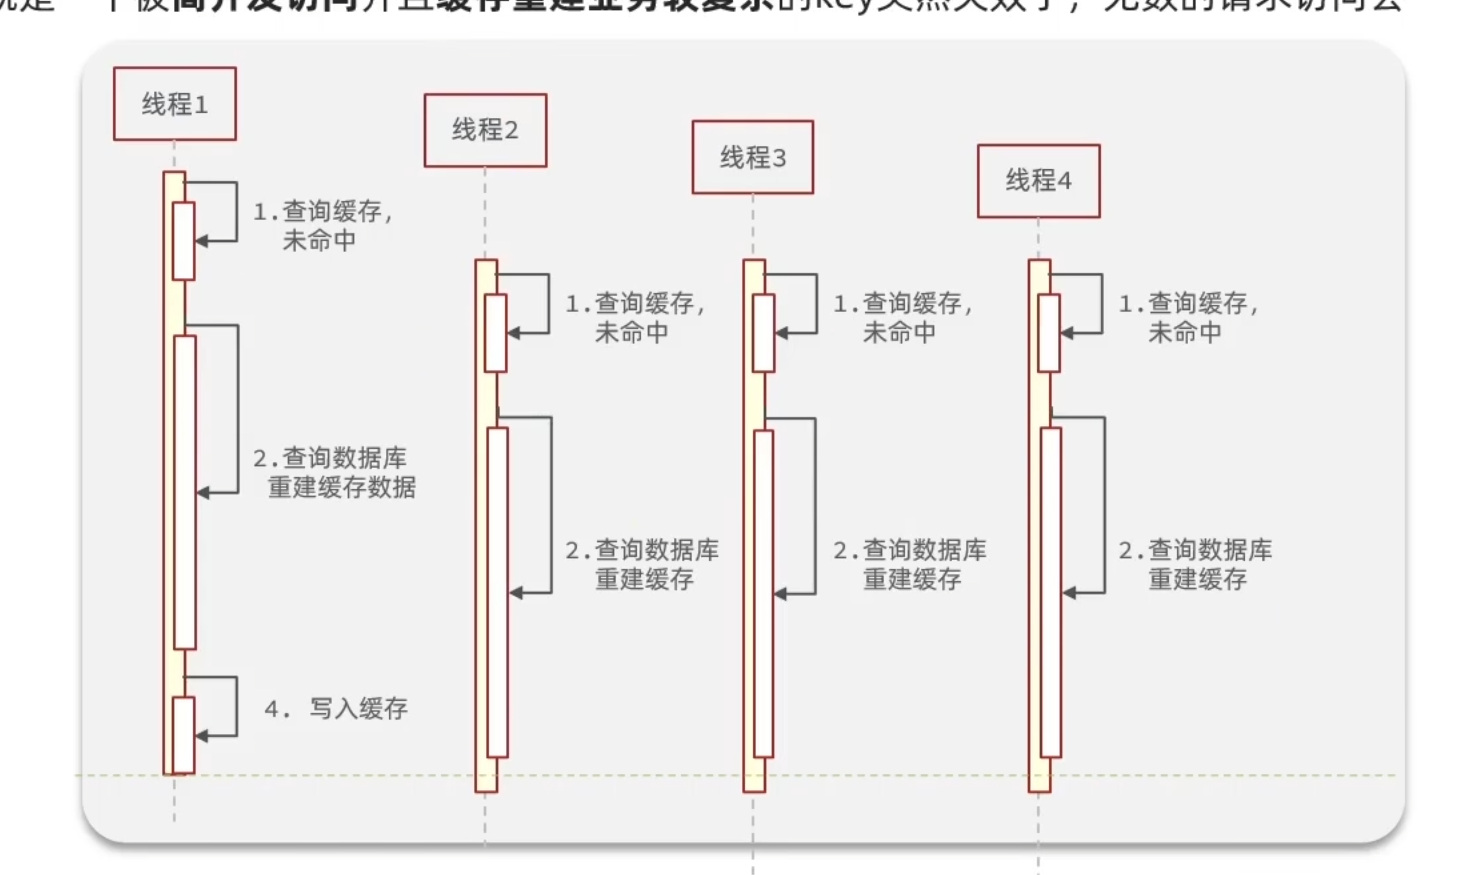
解决:互斥锁或逻辑过期。
互斥锁
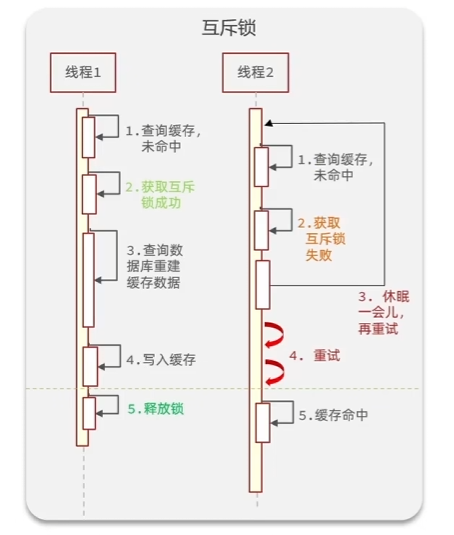
线程A发现缓存过期,加锁重建缓存,后续线程阻塞直至线程A释放锁,此时缓存重建成功。
优点:
- 没有额外的内存消耗
- 保证一致性
- 实现简单
缺点:
- 线程需要等待,性能受影响
- 可能有死锁风险
逻辑过期
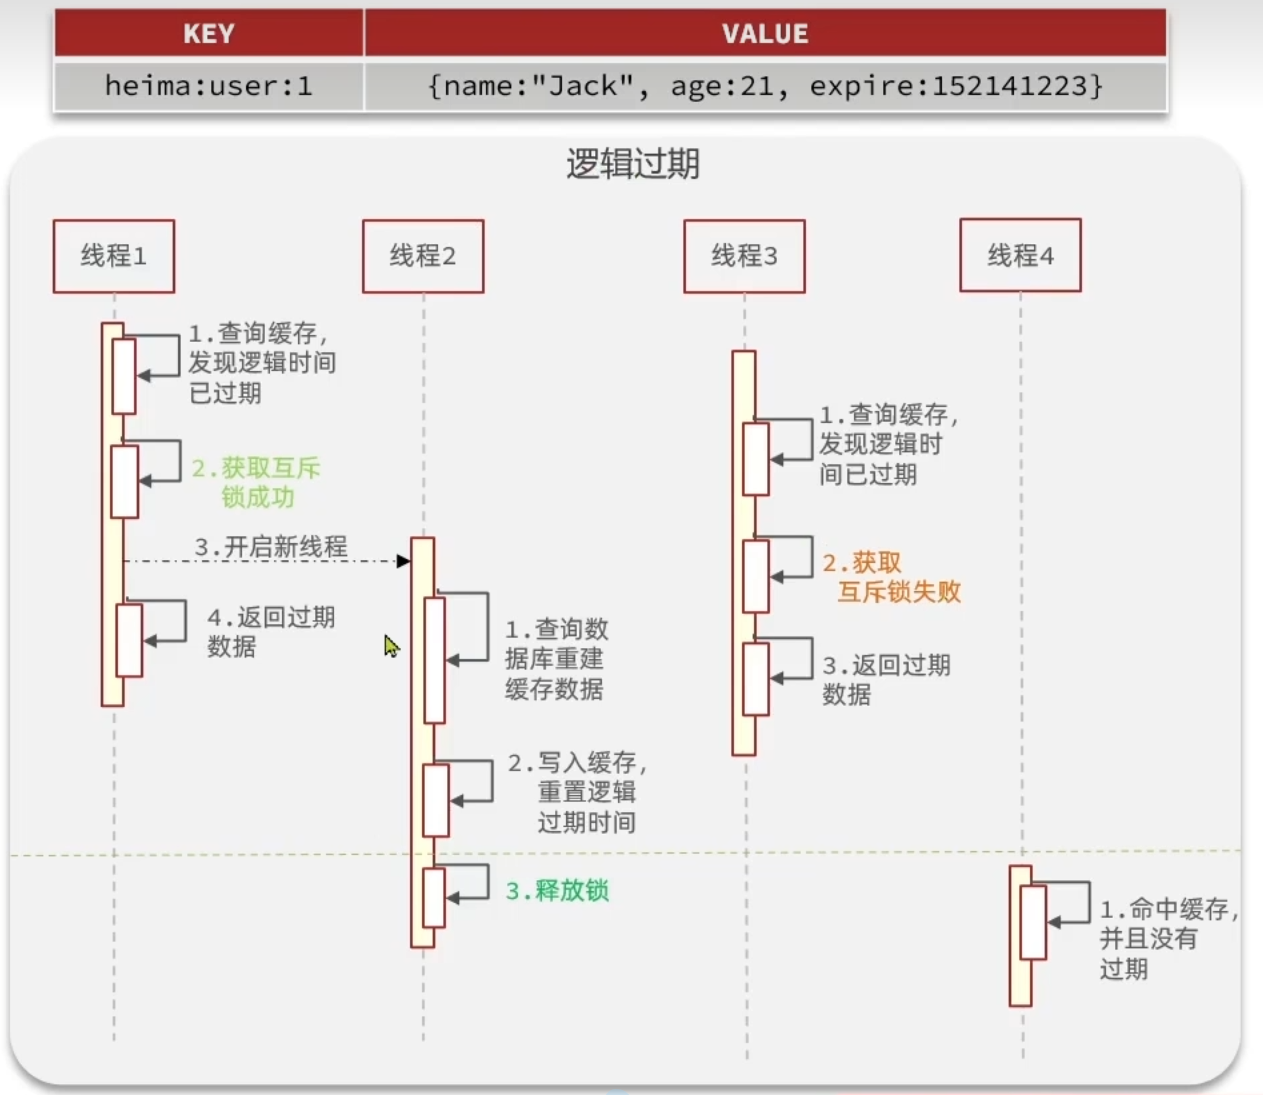
不设置过期时间,但在value中添加逻辑过期字段,线程A查询热点key发现value中逻辑时间过期,则线程A加锁并另起线程B重建缓存,线程A直接返回旧数据(不需等待线程B执行结束),后续线程C查询缓存发现过期后尝试加锁,如果加锁失败则说明有线程正在重建缓存,线程C也直接返回旧数据即可。
优点:
- 线程无需等待,性能较好
缺点:
- 不保证一致性
- 有额外内存消耗
- 实现复杂
优惠券秒杀
全局唯一id
对于优惠券订单,如果使用数据库自增ID会存在以下问题:
- id的规律性太明显
- 受单表数据量的限制
因此需要一种在分布式系统下用来生成全局唯一ID的生成器。
解决方案:利用Redis中String结构的自增INCR命令。

其他全局唯一ID生成策略:
- UUID
- snowflake雪花算法
- 数据库自增
超卖问题
超卖问题
在并发情况下,可能出现类似下图的情况,此时会出现商品超卖问题。
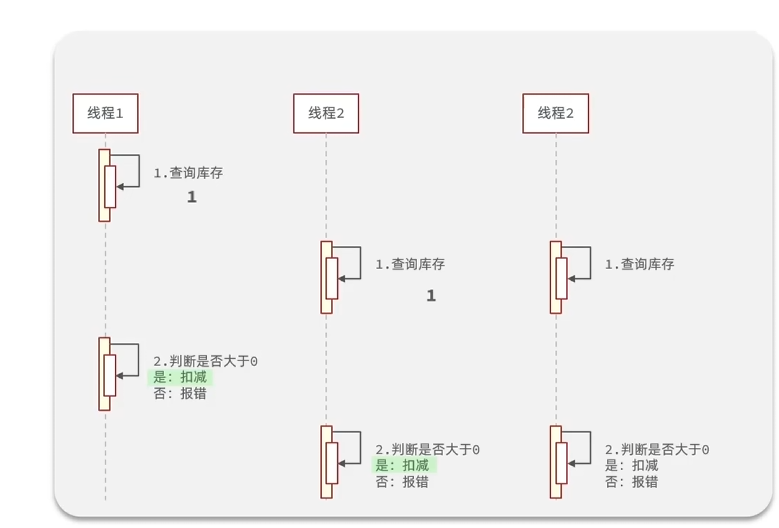
为了解决这种情况,就需要加锁,锁有悲观锁和乐观锁两种。
悲观锁:
- 认为线程安全问题一定会发生,因此在操作数据之前先获取锁,确保线程串行执行。
- 例如Synchronized、Lock都属于悲观锁。
乐观锁:
- 认为线程安全问题不一定会发生,因此不加锁,只是在更新数据时去判断有没有其他线程对数据做了修改。
- 如果没有修改则认为是安全的,自己才更新数据。
- 如果已经被其他线程修改说明发生了安全问题,此时可以重试或异常。
在优惠券秒杀中,使用悲观锁使得线程串行执行,性能较差,因此使用乐观锁。
两种乐观锁
版本号法:给数据加上一个版本,每一次修改数据变化一次版本,多线程并发情况下,基于版本号来判断数据是否被修改过。
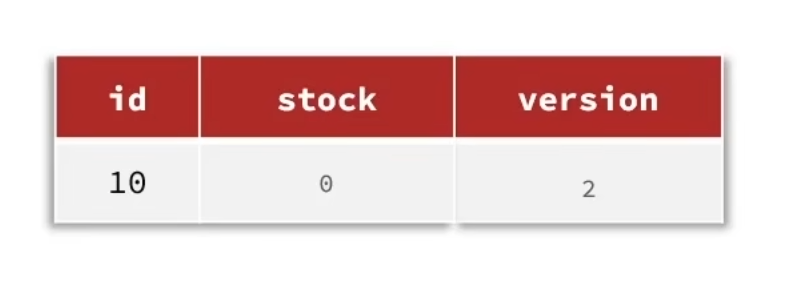
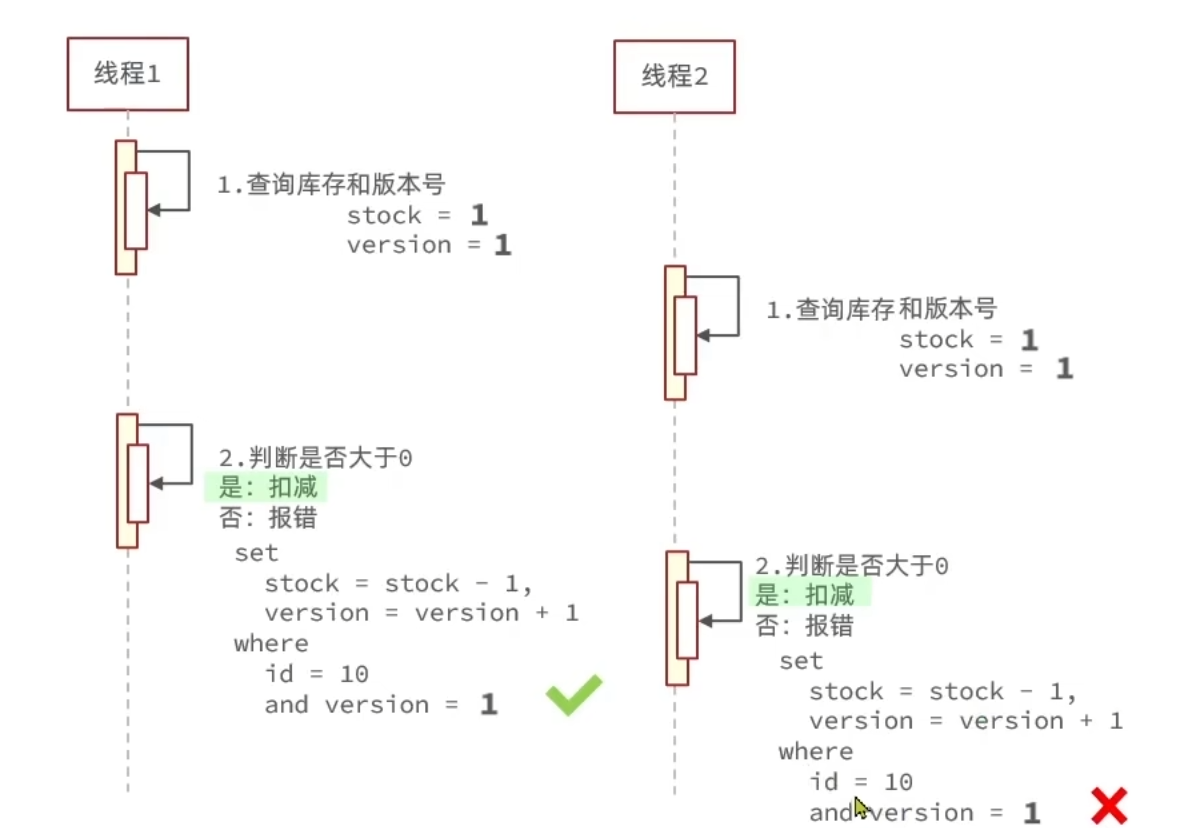
CAS法(Compare and SET):用数据本身是否变化来作为版本,即每次修改数据前,判断数据是否与修改前一致。
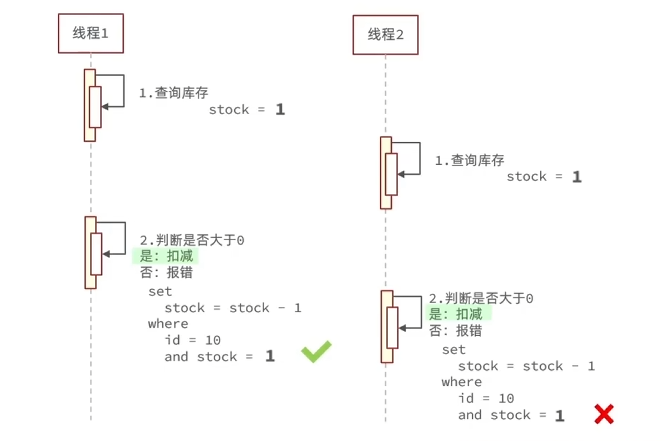
1 | boolean success = seckillVoucherService.update() |
但这种情况下,可能出现失败率高的问题,即多个线程同时尝试,只有一个成功。
可以做个简单的改进,直接判断更新数据时库存是否大于0。
1 | boolean success = seckillVoucherService.update() |
一人一单问题与分布式锁
对于同一张优惠券,可能出现一个用户购买多次情况,为阻止这种情况,需要实现一人一单。
直接判断用户是否下过订单,在并发情况下仍然会出现问题(即一个人同一时刻购买多次),简单的想法是给userId加一个synchronized锁。注意,给userId加synchronized锁时,要写成下面这种。这是由于toString()返回的是一个新的string对象,而我们需要的是判断值是否一样,因此调用intern方法。
1 | synchronized (userId.toString().intern()) {...} |
此外,假如我们给创建订单createVoucherOrder方法加了@Transcational事务注解,那么synchronized锁应该加在方法外面。如果加在里面,可能会出现事务还未提交,锁就被释放,其他线程趁虚而入而数据库还未更新的情况。
使用synchronized锁,在集群部署情况下(多个tomcat),仍然会出现并发安全问题,不同jvm下的线程无法实现锁互斥,如下:

因此需要采用一种集群模式下多进程可见的分布式锁。常见的三种分布式锁:

Redis分布式锁
利用redis的SETNX命令可以实现一个满足互斥锁;同时设置EX过期时间,保证故障时锁依然能被释放,避免死锁。
获取锁:
1 | SET lock thread1 NX EX 10 |
释放锁
1 | DEL key |

这种实现可能出现这样的安全问题:当线程1某种原因阻塞时,超时释放锁,其他线程获取锁后,线程1恢复后可能会释放其他线程获取的锁。

为了解决该问题,为了解决该问题,在释放锁时应该判断是否是自己的锁,只有是自己的锁才允许释放。

但这时仍然有可能出现问题,如下图,当线程1获取锁标识并判断一致后,还未释放锁时遇到阻塞(如jvm垃圾回收),导致后面又释放了其他线程的锁。

因此必须确保判断锁标识动作和释放锁动作的原子性,可以使用Lua脚本。
Redis的Lua脚本
Redis提供了Lua脚本功能,在一个脚本中编写多条Redis命令,确保多条命令执行时的原子性。
1 | -- 获取锁中的线程标识 get key |
Redisson
基于Redis实现的分布式锁有以下问题:
- 不可重入:同一个线程无法多次获取同一把锁。
- 不可重试:获取锁只尝试一次就返回false,没有重试机制。
- 超时释放:锁超时释放虽然可恶意避免死锁,但如果是业务执行耗时较长,也会导致锁释放,存在安全隐患。
- 主从一致性:如果Redis提供了主从集群 ,主从同步存在延迟,当主节点宕机时,如果从节点尚未同步主节点中的锁数据,则会出现锁丢失。
因此使用Redisson来优化。Redisson是一个在Redis的基础上实现的Java驻内存数据网格(In-Memory Data Grid)。它不仅提供了一系列的分布式的Java常用对象,还提供了许多分布式服务,其中就包含了各种分布式锁的实现。
Redisson原理:
可重入
可重入锁:同一个线程多次请求锁,可能会造成死锁。因此需要允许可重入锁。
利用redis中的hash数据结构,为锁额外记录一个值,代表该锁的重入次数。

同一个线程每重入一次锁,将值+1,释放锁改为将值-1,值为0时才真正释放锁。

为保证原子性,同样要使用Lua脚本。
重试机制与超时续约
redisson可以设置等待时间waitTime,在获取锁失败后,会订阅并等待释放锁的信号,然后进行重试,直到获取锁成功或waitTime消耗完。
redisson中的watchdog在获取锁时设置了一个定时任务,每隔一段时间刷新锁的有效期(releaseTime/3),直到释放锁时取消定时任务。注意,如果设置了leaseTime就没有watchdog了。

主从一致性问题
问题产生原因:

redisson解决方案:MultiLock
将每一个redis节点都视为主节点,只有向每个节点获取锁成功,才算成功。此时如果一个redis节点宕机,并不影响锁的正常获取和释放。此外也可以给每个节点建立主从关系,此时如果一个主节点宕机且刚好没有完成同步,由于从节点没有锁的标识,其他线程也无法成功获取锁,满足要求。


异步秒杀
原理
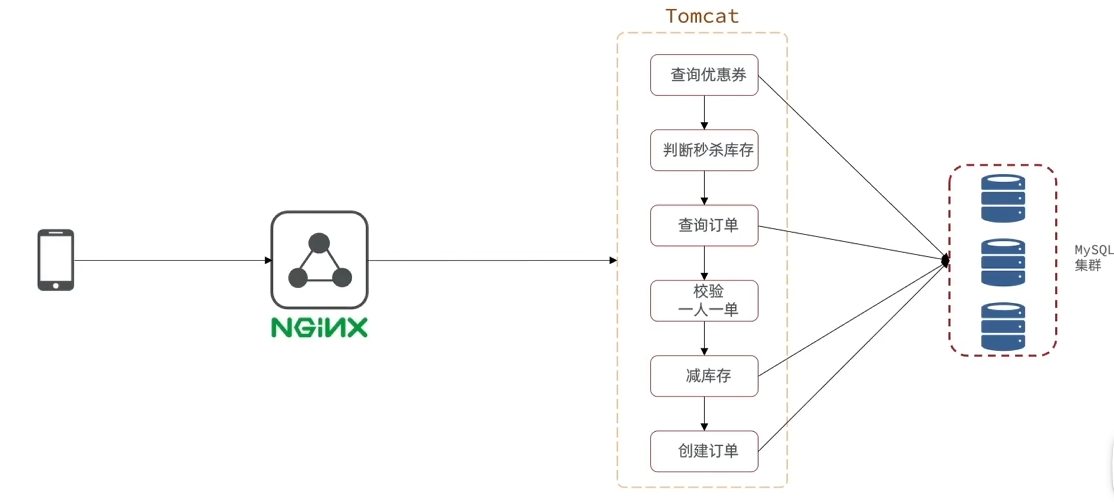
上图是秒杀业务的部署图,按照顺序进行每个步骤,耗时为所有步骤之和,其中一些业务还需要访问mysql,导致整个流程缓慢,效率低。因此需要用到异步秒杀。
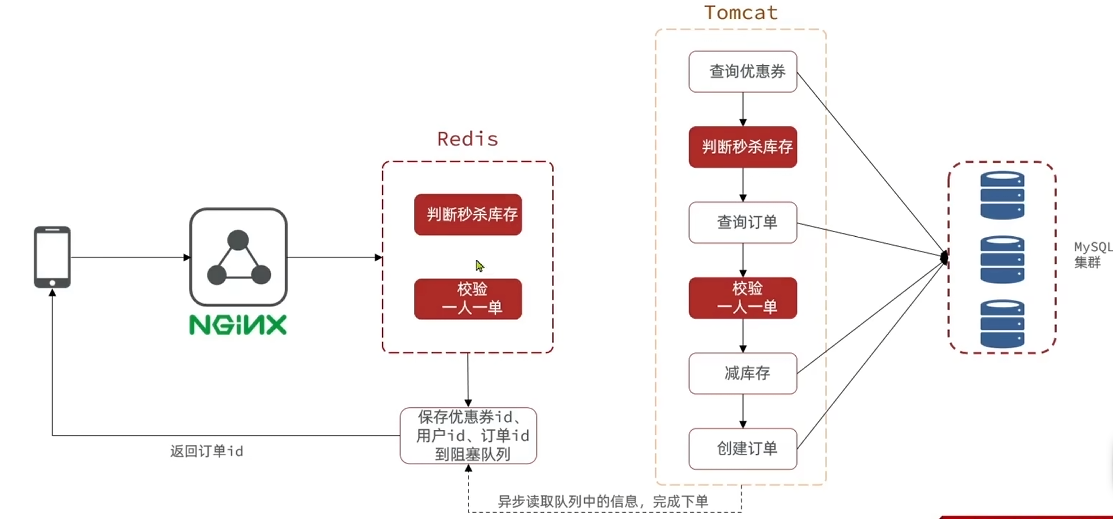
可以采用异步执行的方式来进行优化整个流程,即开启新的线程去执行比较耗时的操作。
将判断库存与校验一人一单的工作让redis执行,如果符合条件,添加订单到阻塞队列,让异步程序再执行。
库存判断使用redis的string数据结构即可,而一人一单则使用set数据结构。同样,为保证redis业务的原子性,使用lua脚本。
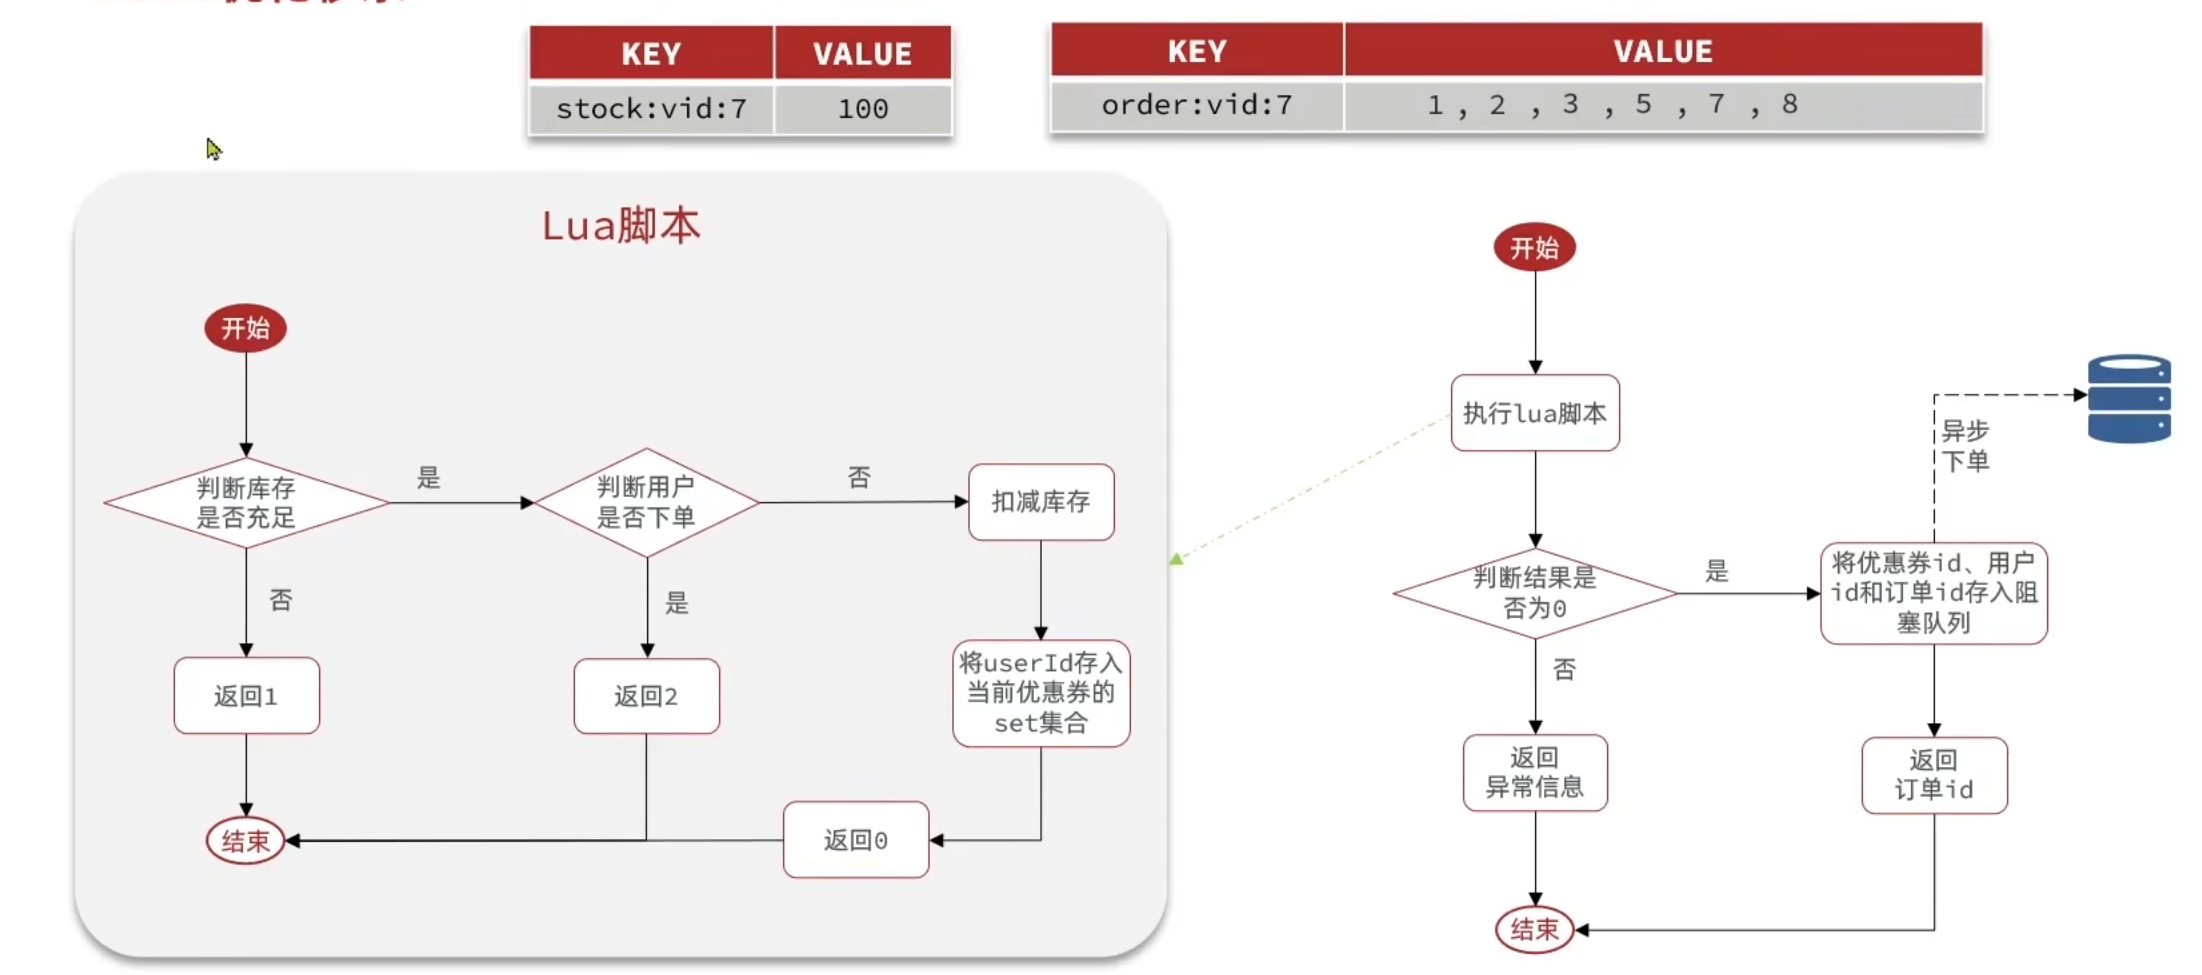
但是基于阻塞队列的异步秒杀存在以下两问题:
- 内存限制问题:使用jdk的阻塞队列会消耗jvm内存,在高并发情况下可能导致内存溢出。而如果设置队列上限会导致超出的订单无法添加。
- 数据安全问题:如果服务宕机,会导致内存中的订单信息丢失。如用户下单付款后,但后台并没有订单数据,出现数据不一致情况。或者异步任务从队列中取出任务执行时,服务崩溃,那么任务就会丢失。
《解析极限编程——拥抱变化》读书笔记
一、书名和作者
- 书名:《解析极限编程——拥抱变化》(Extreme Programming Explained: Embrace Change)
- 作者:Kent Beck
二、书籍概览
- 主要论点和结构
本书是极限编程(Extreme Programming,简称XP)领域的开山之作,书中提出了一种以“拥抱变化”为核心的软件开发方法论。全书结构清晰,主要分为概念介绍、核心实践、以及具体案例剖析三部分。通过理论与实践的结合,本书展示了XP如何通过短迭代、持续反馈、以及团队协作应对软件开发中的不确定性和复杂性。 - 目标读者和应用场景
本书适合从事敏捷开发、项目管理以及软件架构设计的开发者和管理者阅读,同时对希望改进团队协作与开发效率的开发团队具有启发意义。书中的思想既可以应用于小型敏捷团队,也能为传统开发模式的改进提供借鉴。
《人件》读书笔记
一、书名和作者
- 书名:《人件》(Peopleware)
- 作者:Tom DeMarco、Timothy Lister
二、书籍概览
主要论点和结构
《人件》通过探讨软件工程中的“人”这个核心要素,颠覆了传统关注于技术和流程的工程管理理念。书中提出,人是影响软件开发成功与否的关键因素,而非仅仅是生产工具,必须重视人的需求和工作环境的优化。德马科和李斯特基于大量的真实案例和数据,论证了创造良好工作环境的重要性,以及如何通过有效的管理方法实现团队生产力的提升。全书分为若干主题,包括工作场所设计、激励、团队管理等,旨在帮助管理者提升团队的协作效率。
目标读者和应用场景
这本书适合软件工程管理领域的从业者、项目经理,以及希望提升团队管理能力的技术人员。它尤其适用于希望在实践中运用人性化管理方法的人员,以改善团队氛围,增强生产力。
《人月神话》读书笔记
一、书名和作者
- 书名:《人月神话》(The Mythical Man-Month)
- 作者:弗雷德里克·布鲁克斯(Frederick P. Brooks)
二、书籍概览
- 主要论点和结构
该书是一本关于软件工程和项目管理的经典著作,围绕“人月”的概念展开,解释了为什么增加人员不能按比例缩短项目时间。布鲁克斯通过多年的管理经验,提出了影响项目开发成功的核心因素,如沟通、团队管理、项目规划等。全书由多个章节组成,涵盖了软件开发的方方面面,包括项目延迟的根本原因和有效的管理策略。 - 目标读者和应用场景
该书适合软件工程师、项目经理以及对软件开发过程有兴趣的人员。其理论可用于大型软件项目的管理,尤其适合管理复杂的团队协作和解决项目延期问题。